Technischer Hintergrund der Ganganalyse
Für alle, die es genauer wissen möchten
Du möchtest wissen, wie aus einer Videoaufnahme messbare Bewegungsdaten werden? Hier gehen wir etwas tiefer in den technischen und wissenschaftlichen Hintergrund unserer Ganganalyse.
Objektive Bewegungsanalyse per 2D-Video
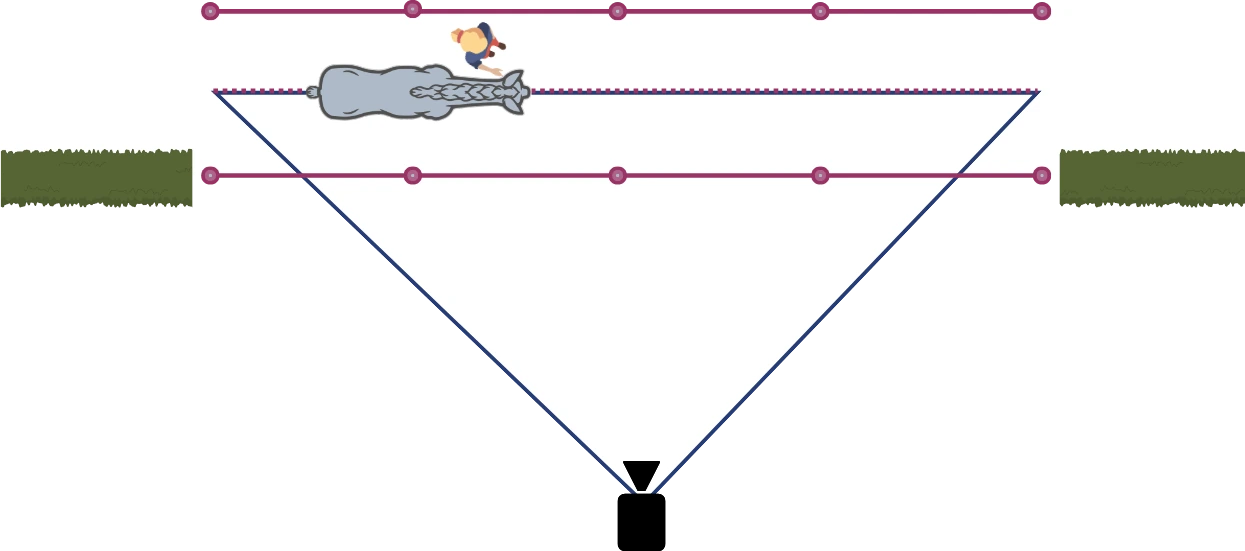
Die Ganganalyse basiert auf einer zweidimensionalen Videoanalyse. Dabei wird das Pferd von der Seite aufgenommen, während es im Trab eine definierte Messstrecke entlanggeführt wird. Im Gegensatz zu markerbasierten Verfahren müssen am Pferd dabei keine Sensoren oder Marker angebracht werden. 3D-Bewegungserfassungssysteme können Bewegungen räumlich sehr detailliert erfassen, sind jedoch deutlich aufwendiger und teurer. Die 2D-Videoanalyse bietet eine praktikablere Möglichkeit, bestimmte Bewegungsverläufe unter standardisierten Bedingungen zu erfassen.
Weshalb ein standardisierter Messaufbau so wichtig ist
Damit die aufgezeichneten Bewegungen möglichst vergleichbar sind, ist ein standardisierter Messaufbau entscheidend. Die Kamera wird in einem definierten (berechneten) Abstand und möglichst exakt senkrecht zur Bewegungsrichtung aufgestellt. Dadurch entsteht eine Referenzebene, die sogenannte Plane of Motion (POM). Bewegt sich das Pferd deutlich aus dieser Ebene heraus, können perspektivische Verzerrungen und Parallaxeneffekte entstehen. Dabei können sich die scheinbaren Positionen und Größen von Orientierungspunkten im Bild verändern. Der Einfluss solcher Verzerrungen nimmt unter anderem mit dem Abstand des Objekts von der kalibrierten Ebene zu.
Der Messaufbau berücksichtigt deshalb die Kameraposition, den Aufnahmeabstand und die Abmessungen der Messstrecke. Auch die freie Sicht auf die gesamte Strecke ist wichtig, damit die definierten Orientierungspunkte während der Aufnahme möglichst zuverlässig erfasst werden können.
Markerloses Tracking mit künstlicher Intelligenz
Für die automatische Erfassung der Bewegungen wird DeepLabCut™ eingesetzt. Dabei handelt es sich um eine Methode zur markerlosen Posenschätzung, bei der zuvor definierte Körperpunkte anhand von Videobildern erkannt werden. Für die Ganganalyse wurden drei Orientierungspunkte definiert:
- Auge als Orientierungspunkt für den Kopf
- Widerrist
- Kreuzbein
Das verwendete neuronale Netzwerk basiert auf ResNet-50. Für das Training wurden manuell von mir markierte Videobilder verwendet. Das Modell lernt dabei, die Positionen der definierten Orientierungspunkte in neuen Bildern selbstständig zu bestimmen. Die künstliche Intelligenz übernimmt dabei ausschließlich die Erkennung und Positionierung der festgelegten Orientierungspunkte. Sie entscheidet nicht darüber, ob ein Bewegungsmuster physiologisch ist oder nicht.
Von einzelnen Videobildern zu Bewegungskurven
Für jedes Videobild liefert das Modell die Position der erkannten Orientierungspunkte. Über die zeitliche Abfolge dieser Positionen entstehen Bewegungstrajektorien. Für die weitere Analyse werden die aufgezeichneten Bewegungen in einzelne vollständige Bewegungszyklen unterteilt und zeitlich auf einen gemeinsamen Zyklus von 0 bis 100 % normiert.
Nicht verwertbare oder unvollständige Zyklen werden vor der weiteren Auswertung entfernt. Aus den so gewonnenen Bewegungsverläufen können anschließend unter anderem die vertikalen Bewegungen von Kopf, Widerrist und Kreuzbein betrachtet und statistisch beschrieben werden. In meiner Masterarbeit wurden hierfür unter anderem Mittelwerte, Standardabweichungen sowie die maximalen und minimalen vertikalen Positionen der einzelnen Messpunkte betrachtet.
Genauigkeit
Um die Leistung des KI-Modells zu überprüfen, wurden die automatisch ermittelten Positionen mit manuell gesetzten Referenzpunkten verglichen. Als Maß für die Abweichung wurde der Root Mean Square Error (RMSE) verwendet. In der Masterarbeit wurde das verwendete ResNet-50-Modell mit 320 manuell markierten Labels aus 16 Videos trainiert und anschließend getestet. Nach 500.000 Trainingsiterationen lag der durchschnittliche Testfehler über alle drei Orientierungspunkte bei 3,51 Pixeln, entsprechend etwa 21,94 mm unter den Bedingungen der damaligen Untersuchung. Der Trainingsfehler lag bei 2,19 Pixeln bzw. 13,69 mm. Die Werte beschreiben dabei die Genauigkeit der automatischen Erfassung der Orientierungspunkte und nicht die Genauigkeit einer späteren Interpretation des Bewegungsmusters.
Grenzen
Auch eine standardisierte 2D-Videoanalyse ist nicht frei von Messfehlern. Die Genauigkeit kann unter anderem durch die Auflösung und Bildfrequenz der Kamera, die Position des Pferdes innerhalb der Messstrecke, die Sichtbarkeit der Orientierungspunkte und Bewegungen außerhalb der definierten Bewegungsebene beeinflusst werden. In der Masterarbeit zeigte sich außerdem, dass eine höhere Bildauflösung und eine höhere Abtastfrequenz die Genauigkeit der markerlosen Posenschätzung möglicherweise weiter verbessern könnten. Aus diesem Grund sind ein möglichst konstanter Messaufbau, mehrere verwertbare Bewegungszyklen und eine sorgfältige Kontrolle des Videomaterials wichtige Bestandteile der Auswertung.
Von der Messung zur Auswertung
Die künstliche Intelligenz liefert ausschließlich die Positionsdaten der einzelnen Orientierungspunkte. Daraus entstehen die charakteristischen Bewegungskurven, die anschließend im Zusammenhang mit der aktuellen wissenschaftlichen Literatur betrachtet werden. Die Technik liefert also ausschließlich die Messdaten; die Interpretation der Ergebnisse erfolgt auf Grundlage dieser Daten und der wissenschaftlichen Literatur. Warum dafür künstliche Intelligenz eingesetzt wird, wird schnell deutlich: Ein durchschnittliches Video dauert etwa 4 Sekunden und wird mit 60 Bildern pro Sekunde aufgenommen. Damit entstehen bereits bei einer einzigen Aufnahme rund 240 Einzelbilder. Würde man in jedem Bild drei Orientierungspunkte manuell markieren und das für mehrere Videos wiederholen, wäre die Auswertung nicht nur extrem zeitaufwendig, sondern auch sehr fehleranfällig.
Genau hier spielt die automatische Erfassung der Orientierungspunkte ihre Stärke aus. In meiner Masterarbeit wurden 320 Bilder manuell beschriftet, um das KI-Modell zu trainieren. Interessanterweise war die Abweichung zwischen wiederholten Beschriftungen durch mich mit 4,72 Pixeln sogar größer als der Testfehler des trainierten Modells mit 3,51 Pixeln. Das zeigt auch, dass nicht nur eine künstliche Intelligenz Fehler machen kann: Schon die menschliche Beurteilung eines bestimmten Punktes in einem einzelnen Videobild ist nicht immer exakt reproduzierbar.
Die Technik liefert also die Messdaten, wohingegen die Interpretation der Ergebnisse auf Grundlage dieser Daten und wissenschaftlicher Literatur erfolgt.